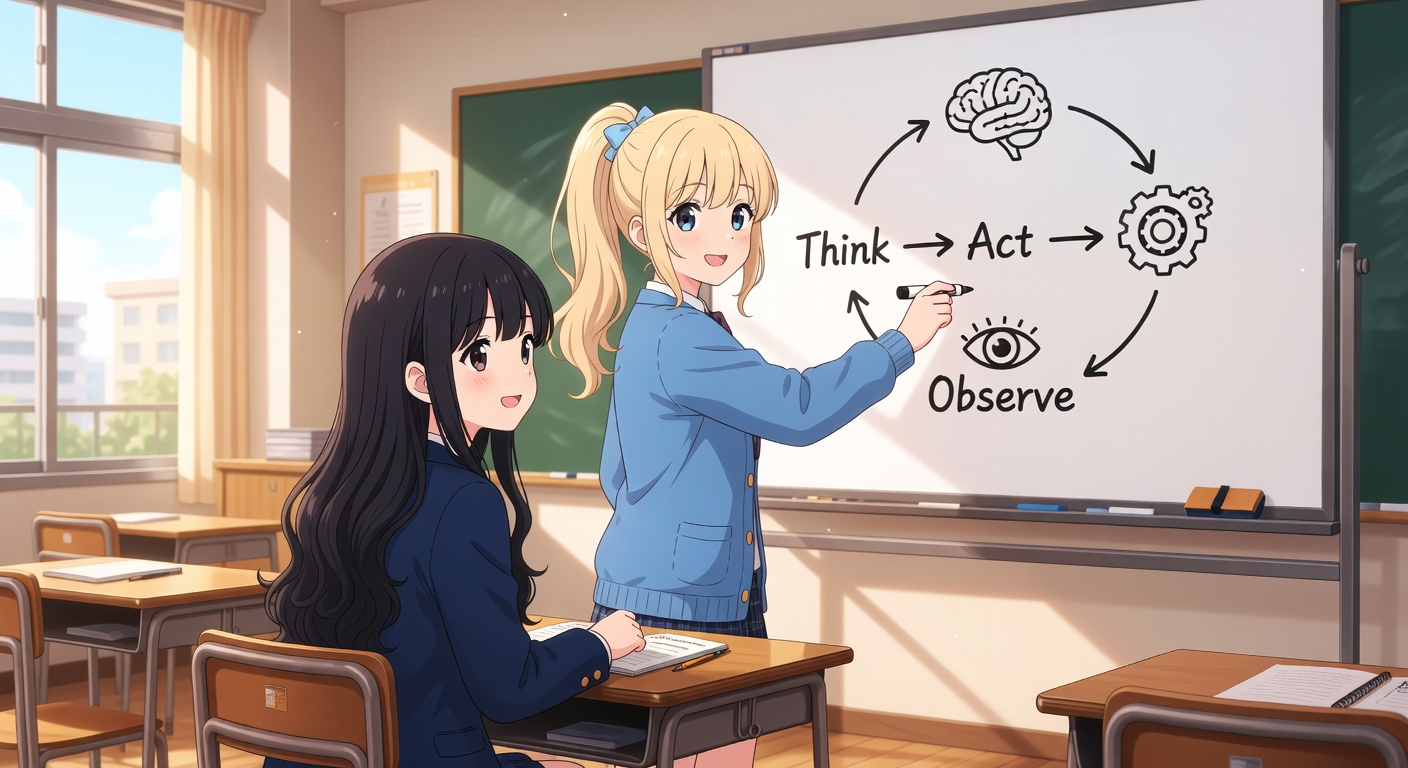
🔄 AIが一人で働く秘密
これまで私たちはAIエージェントの核心部品をひとつずつ学んできましたね。第2話では頭脳(LLM)、第3話では手(Tool Use)、第4話では記憶(コンテキストとメモリ)を学びました。
でも、これらの部品があるだけでエージェントになれるでしょうか?違います!この三つをつなぎ合わせて、自ら繰り返す構造が必要なんですよ。それが今日学ぶAgent Loop(エージェントループ)です。
ちょっと待って、「ループ」って何でしょ?ただAIに聞けば勝手にやってくれるんじゃない?
いい質問ですね!一回聞いて一回答えるのはただの「チャットボット」ですよ。エージェントは目標を達成するまで、自ら考えて、行動して、結果を確認することを繰り返します。その繰り返しの構造がループなんです!
例を挙げてみましょう。Claude Codeに「このバグを直して」と言うと、こんなことが起きます:
- コードを読んで問題を分析する(考える)
- ファイルを修正する(行動する)
- テストを実行して結果を確認する(観察する)
- テストが失敗したら? → 再び1番へ!
このプロセスが平均21.2回のツール呼び出しを人間の介入なしに実行するそうです(Anthropic公式ドキュメント)。一回聞いて終わりのチャットボットとは完全に次元が違いますね!
AIエージェントが目標を達成するまで「考える → 行動する → 観察する」を繰り返す核心的な動作構造ですよ。まるで料理人が「レシピ確認 → 調理 → 味見」を繰り返すようなものです!
🧠 Think → Act → Observe — 三段階のサイクル
エージェントループは三つの段階で構成されています。

1. Think(考える) — LLMが現在の状況を分析し、次に何をするかを決めます。「このコードにnullチェックが抜けている。修正しなければ」というようにね。
2. Act(行動する) — 決定に従ってツールを呼び出します。ファイルを読んだり、コードを修正したり、検索したり。第3話で学んだTool Useがここで輝きますよ!
3. Observe(観察する) — 行動の結果を確認します。ツールが返した結果を見て「成功した?まだやることがある?」を判断します。
じゃあこのサイクルって永遠に回り続けるでしょ?
違いますよ!目標を達成したらループが終わります。より正確に言うと、LLMが「もうツールを呼び出す必要がない」と判断したとき、最終的な答え(テキスト)だけを返してループが終了します。
📜 ReActパターン — 学術的な起源
この「考えて行動する」パターンには公式な名前がありますよ。それがReActです。
推論(Reasoning)と行動(Acting)を交互に行うAIエージェントパターンですよ。2022年にプリンストン大学とGoogleが発表した論文で提案されました。
2022年10月、プリンストン大学とGoogleの研究チームが「ReAct: Synergizing Reasoning and Acting in Language Models」という論文を発表しました。この論文はICLR 2023に掲載され、AIエージェント研究の基礎となりましたよ。
ReActの核心アイデアはシンプルです:
- 推論(Thought)が行動計画を立て、例外を処理します
- 行動(Action)が外部の情報源とやりとりします
- この二つを交互に行うことで、単独よりずっと強力になります
実際の実験では、ReActはWikipedia検索タスク(HotpotQA)でhallucination(幻覚)とエラーの伝播を大幅に削減し、ゲーム環境(ALFWorld)では従来の方法と比べて34%高い成功率を記録しましたよ。
じゃあClaude CodeもReActパターンを使ってるでしょ?
そうです!Claude Codeの公式ドキュメントを見ると三段階が混合された形ですよ — コンテキスト収集(gather context) → 行動(take action) → 結果検証(verify results)。名前は少し違いますが、本質はReActと同じです!
⚙️ ClaudeのAgent Loop — 実際の実装
Claude Agent SDKのエージェントループはこのように動作します:
- プロンプト受信 — ユーザーのリクエスト + システムプロンプト + ツール定義 + 会話履歴
- 評価/応答 — Claudeがテキスト、ツール呼び出し、またはその両方を返す
- ツール実行 — SDKがツールを実行して結果を収集
- フィードバック — 結果を再びClaudeに渡す
- 繰り返し — 2〜4のステップを繰り返し、ツール呼び出しがなければ終了
コードで見ると驚くほどシンプルです。核心はwhileループですよ:
# Claude Agent Loopの核心構造(擬似コード)
while True:
    # 1. LLMに現在の状況を渡す
    response = claude.send(messages)

    # 2. ツール呼び出しがあるか確認
    if not response.has_tool_calls():
        # ツール呼び出しなし → 最終回答!
        print(response.text)
        break

    # 3. ツール実行 & 結果収集
    for tool_call in response.tool_calls:
        result = execute_tool(
            tool_call.name,
            tool_call.arguments
        )
        # 4. 結果を会話に追加
        messages.append(
            tool_result(result)
        )
このシンプルな構造がClaude Codeのすべての魔法の源です。max_turnsやmax_budget_usdといった安全装置があるので、無限に回り続けることはありませんよ。
max_turns(最大繰り返し回数)、max_budget_usd(コスト上限)、effortレベル(low/medium/high/max)でエージェントの動作範囲を制御できますよ。
💻 自分で作ってみよう! — ミニエージェントループ
それでは私たちも直接エージェントループを作ってみましょう!簡単な「天気照会エージェント」ですよ。
import anthropic, json

client = anthropic.Anthropic()
MAX_TURNS = 10  # 無限ループ防止!

# ツール定義
tools = [{
    "name": "get_weather",
    "description": "都市の現在の天気を照会",
    "input_schema": {
        "type": "object",
        "properties": {
            "city": {
                "type": "string",
                "description": "都市名"
            }
        },
        "required": ["city"]
    }
}]

# ツール実行関数
def run_tool(name, args):
    if name == "get_weather":
        city = args["city"]
        return f"{city}: 晴れ、22°C"
    return "不明なツール"

# 🔄 エージェントループ!
messages = [{"role": "user",
  "content": "東京とソウルの天気を比較して"}]

for turn in range(MAX_TURNS):
    resp = client.messages.create(
        model="claude-sonnet-4-20250514",
        max_tokens=1024,
        tools=tools,
        messages=messages
    )

    # テキストのみが来たら → ループ終了
    if resp.stop_reason == "end_turn":
        for block in resp.content:
            if hasattr(block, "text"):
                print(block.text)
        break

    # ツール呼び出し処理
    messages.append(
        {"role": "assistant",
         "content": resp.content})

    for block in resp.content:
        if block.type == "tool_use":
            result = run_tool(
                block.name,
                block.input
            )
            messages.append({
                "role": "user",
                "content": [{
                    "type": "tool_result",
                    "tool_use_id": block.id,
                    "content": result
                }]
            })
            print(f"[Turn {turn+1}]"
                  f" {block.name}"
                  f"({block.input})"
                  f" → {result}")
else:
print("⚠️ 最大ターン数超過!")このコードの核心をまとめますね!
for turn in range(MAX_TURNS)— 安全に最大回数を制限- LLMがツールを呼び出したら → 実行して結果を返す
- LLMがテキストのみを返したら → 最終回答、ループ終了!
「東京とソウルの天気を比較して」と言うと、エージェントはget_weather("東京") → get_weather("ソウル")を順に呼び出した後、結果を比較して最終回答を作ります。Think → Act → Observeが自動的に起きるんですよ!
全体のコードはGitHubリポジトリで確認できますよ。
⚔️ ReAct vs Plan-and-Execute
エージェントループには二つの代表的な戦略がありますよ。

ReAct(反応型) — 毎ステップで考えてすぐに行動します。柔軟ですが、全体的な大きな絵を見失うことがあります。
Plan-and-Execute(戦略型) — まず全体の計画を立てて、順番に実行します。より正確ですが、計画段階でトークンをたくさん使います。
| 比較項目 | ReAct | Plan-and-Execute |
|---|---|---|
| 方式 | 毎ステップ 考える→行動 | 計画先行 → 順次実行 |
| トークン使用 | 2,000〜3,000 | 3,000〜4,500 |
| 精度 | 85% | 92% |
| API呼び出し | 3〜5回 | 5〜8回 |
| 適した状況 | シンプルな反応型タスク | 複雑なマルチステップタスク |
実際の現場ではどちらか一方だけを使うんでしょ?
違いますよ!実際の現場ではハイブリッドが多いんです。全体の戦略はPlan-and-Executeで、各ステップの実行はReActで、というやり方ですよ。Claude Codeもこういったハイブリッド方式なんです!
⚠️ エージェントループが失敗するとき
エージェントループは強力ですが、失敗することもあります。2025年の研究によると、マルチエージェントシステムの失敗率は41〜86.7%にも達するそうです(arXiv:2503.13657)。
代表的な失敗モードを見てみましょう:
| 失敗モード | 説明 | 例 |
|---|---|---|
| 🔄 無限ループ | 同じ行動を繰り返す | 同じ回答を58回繰り返し出力 |
| 🔁 再帰的失敗 | 失敗したアプローチを再試行 | うまくいかない方法を100回再試行 |
| 💬 会話の循環 | 終了タイミングがわからない | エージェント同士で延々と確認要求 |
| ✅ 早期完了 | 未完成なのに完了宣言 | 「できました!」(実はできていない) |

じゃあエージェントが無限ループにはまったらどうするの?電気代が爆発するんじゃない?
だからmax_turnsみたいな安全装置があるんですよ!まるでラーメンのタイマーみたいにね〜
…クロディ、あなたもたまにラーメンのタイマーセットし忘れてふやかしたことあるじゃない?
あれは…意図的なやわらかめだったんですよ!😤
失敗を防ぐためにはこういった安全装置が必須ですよ:
- 繰り返し回数制限 —
max_turnsでハードキャップを設定 - コスト制限 —
max_budget_usdで支出上限を設定 - 進捗追跡 — 毎ターンの進行状況を記録
- 結果検証 — ユニットテストだけでなくend-to-end検証も実施
💰 隠れたコスト — トークン消費
エージェントループには隠れたコストがあります。毎ターン、システムプロンプト + ツール定義 + 会話履歴全体 + ツールの入出力が累積されるからです。
OpenReviewの研究によると、同じコーディングタスクでもエージェントによってトークン消費が10倍違うこともあるそうです。実行前にコストを予測するのはほぼ不可能です(相関係数 r < 0.15)。
そのためClaude Agent SDKはこのような最適化を行っていますよ:
- 自動圧縮(Compaction) — コンテキストが長くなると以前の内容を要約
- プロンプトキャッシング — 繰り返されるシステムプロンプトをキャッシング
- サブエージェント — 独立したタスクを別のエージェントに分離してコンテキスト爆発を防止

📝 今日の核心まとめ
- Agent Loop(エージェントループ)は「Think → Act → Observe」を繰り返す構造ですよ。これがチャットボットとエージェントを区別する核心です。
- ReActパターンは推論(Reasoning)と行動(Acting)を交互に行う方式で、2022年のプリンストン大学+Googleの論文で提案されましたよ。
- Claude Codeの核心はwhileループ一つですよ — ツール呼び出しがあれば続行、なければ終了!
- エージェントループには無限ループ、再帰的失敗などのリスクがあるため、
max_turnsのような安全装置が必須ですよ。 - トークンコストが毎ターン累積されるため、自動圧縮とサブエージェントで最適化する必要がありますよ。
- 次の話では、このエージェントループに「個性」を与えるシステムプロンプト設計を学びますよ!
📚 References
- ReAct: Synergizing Reasoning and Acting in Language Models (Yao et al., 2022)
- Anthropic — How Claude Code Works
- Claude Agent SDK — How the Agent Loop Works
- Hugging Face — Agents Course: Thought-Action-Observation
- IBM — What is a ReAct Agent?
- Why Do Multi-Agent LLM Systems Fail? (2025)
- ReAct vs Plan-and-Execute: A Practical Comparison
- Anthropic — Effective Harnesses for Long-Running Agents
- How Do Coding Agents Spend Your Money? (OpenReview, 2025)
- Google Research — ReAct Blog Post
- クロディのAgentic AI教室 第2話 — LLMって何?
- クロディのAgentic AI教室 第3話 — Tool Useの世界
- クロディのAgentic AI教室 第4話 — コンテキストとメモリ