🔄 AI가 혼자서 일하는 비밀
지금까지 우리는 AI 에이전트의 핵심 부품을 하나씩 배워왔어요. 2편에서 두뇌(LLM), 3편에서 손(Tool Use), 4편에서 기억(컨텍스트와 메모리)을 배웠죠.
그런데 이 부품들만 있으면 에이전트가 될까요? 아니에요! 이 세 가지를 연결해서 스스로 반복하는 구조가 필요해요. 그게 바로 오늘 배울 Agent Loop(에이전트 루프)예요.
잠깐, 그런데 “루프”라는 게 뭔데? 그냥 AI한테 물어보면 알아서 하는 거 아니야?
좋은 질문이에요! 한 번 물어보고 한 번 답하는 건 그냥 “챗봇”이에요. 에이전트는 목표를 달성할 때까지 스스로 생각하고, 행동하고, 결과를 확인하는 걸 반복해요. 그 반복 구조가 루프예요!
예를 들어볼게요. Claude Code에게 “이 버그를 고쳐줘”라고 하면, 이런 일이 일어나요:
- 코드를 읽고 문제를 분석한다 (생각)
- 파일을 수정한다 (행동)
- 테스트를 실행해서 결과를 확인한다 (관찰)
- 테스트가 실패하면? → 다시 1번으로!
이 과정이 평균 21.2번의 도구 호출을 사람 개입 없이 수행한다고 해요 (Anthropic 공식 문서). 한 번 물어보면 끝나는 챗봇과는 완전히 다른 차원이죠!
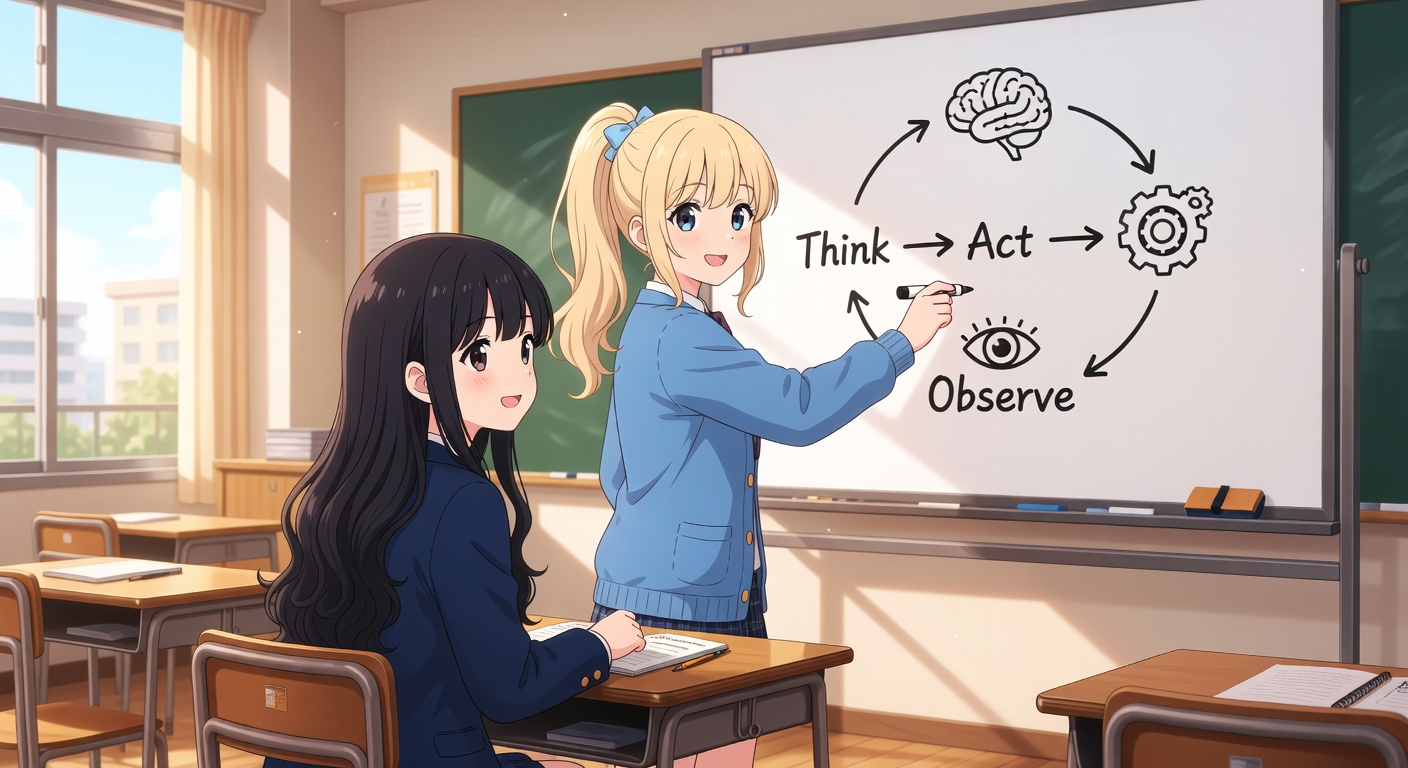
AI 에이전트가 목표를 달성할 때까지 “생각 → 행동 → 관찰”을 반복하는 핵심 동작 구조예요. 마치 요리사가 “레시피 확인 → 조리 → 맛보기”를 반복하는 것과 같아요!
🧠 Think → Act → Observe — 세 단계의 순환
에이전트 루프는 세 단계로 이루어져 있어요.

1. Think (생각) — LLM이 현재 상황을 분석하고 다음에 뭘 할지 결정해요. “이 코드에 null 체크가 빠져있네. 수정해야겠다”처럼요.
2. Act (행동) — 결정에 따라 도구를 호출해요. 파일을 읽거나, 코드를 수정하거나, 검색을 하거나. 3편에서 배운 Tool Use가 여기서 빛나요!
3. Observe (관찰) — 행동의 결과를 확인해요. 도구가 반환한 결과를 보고 “성공했나? 더 할 일이 있나?”를 판단해요.
그러면 이 사이클이 영원히 도는 거야?
아니요! 목표를 달성하면 루프가 끝나요. 더 정확히 말하면, LLM이 “더 이상 도구를 호출할 필요가 없다”고 판단하면 최종 답변(텍스트)만 반환하고 루프가 종료돼요.
📜 ReAct 패턴 — 학술적 기원
이 “생각하고 행동하는” 패턴에는 공식 이름이 있어요. 바로 ReAct예요.
추론(Reasoning)과 행동(Acting)을 번갈아 수행하는 AI 에이전트 패턴이에요. 2022년 프린스턴대와 Google이 발표한 논문에서 제안됐어요.
2022년 10월, 프린스턴대학교와 Google 연구팀이 “ReAct: Synergizing Reasoning and Acting in Language Models”라는 논문을 발표했어요. 이 논문은 ICLR 2023에 게재되면서 AI 에이전트 연구의 기초가 됐어요.
ReAct의 핵심 아이디어는 간단해요:
- 추론(Thought)이 행동 계획을 세우고 예외를 처리해요
- 행동(Action)이 외부 정보원과 상호작용해요
- 이 둘을 번갈아 수행하면 단독보다 훨씬 강력해요
실제 실험에서 ReAct는 위키피디아 검색 과제(HotpotQA)에서 hallucination(헛소리)과 에러 전파를 크게 줄였고, 게임 환경(ALFWorld)에서는 기존 방법 대비 34% 더 높은 성공률을 기록했어요.
그럼 Claude Code도 ReAct 패턴을 쓰는 거야?
맞아요! Claude Code의 공식 문서를 보면 세 단계가 혼합된 형태예요 — 컨텍스트 수집(gather context) → 행동(take action) → 결과 검증(verify results). 이름은 좀 다르지만 본질은 ReAct와 같아요!
⚙️ Claude의 Agent Loop — 실제 구현
Claude Agent SDK의 에이전트 루프는 이렇게 동작해요:
- 프롬프트 수신 — 사용자 요청 + 시스템 프롬프트 + 도구 정의 + 대화 히스토리
- 평가/응답 — Claude가 텍스트, 도구 호출, 또는 둘 다 반환
- 도구 실행 — SDK가 도구를 실행하고 결과를 수집
- 피드백 — 결과를 다시 Claude에게 전달
- 반복 — 2-4단계를 반복, 도구 호출이 없으면 종료
코드로 보면 놀라울 정도로 단순해요. 핵심은 while 루프예요:
# Claude Agent Loop의 핵심 구조 (의사코드)
while True:
    # 1. LLM에게 현재 상황 전달
    response = claude.send(messages)

    # 2. 도구 호출이 있는지 확인
    if not response.has_tool_calls():
        # 도구 호출 없음 → 최종 답변!
        print(response.text)
        break

    # 3. 도구 실행 & 결과 수집
    for tool_call in response.tool_calls:
        result = execute_tool(
            tool_call.name,
            tool_call.arguments
        )
        # 4. 결과를 대화에 추가
        messages.append(
            tool_result(result)
        )
이 단순한 구조가 Claude Code의 모든 마법의 근원이에요. max_turns나 max_budget_usd 같은 안전장치가 있어서 무한히 돌지는 않아요.
max_turns(최대 반복 횟수), max_budget_usd(비용 상한), effort 레벨(low/medium/high/max)로 에이전트의 동작 범위를 제어할 수 있어요.
💻 직접 만들어보자! — 미니 에이전트 루프
이제 우리도 직접 에이전트 루프를 만들어볼게요! 간단한 “날씨 조회 에이전트”예요.
import anthropic, json

client = anthropic.Anthropic()
MAX_TURNS = 10  # 무한 루프 방지!

# 도구 정의
tools = [{
    "name": "get_weather",
    "description": "도시의 현재 날씨를 조회",
    "input_schema": {
        "type": "object",
        "properties": {
            "city": {
                "type": "string",
                "description": "도시 이름"
            }
        },
        "required": ["city"]
    }
}]

# 도구 실행 함수
def run_tool(name, args):
    if name == "get_weather":
        city = args["city"]
        return f"{city}: 맑음, 22°C"
    return "알 수 없는 도구"

# 🔄 에이전트 루프!
messages = [{"role": "user",
  "content": "서울이랑 도쿄 날씨 비교해줘"}]

for turn in range(MAX_TURNS):
    resp = client.messages.create(
        model="claude-sonnet-4-20250514",
        max_tokens=1024,
        tools=tools,
        messages=messages
    )

    # 텍스트만 왔으면 → 루프 종료
    if resp.stop_reason == "end_turn":
        for block in resp.content:
            if hasattr(block, "text"):
                print(block.text)
        break

    # 도구 호출 처리
    messages.append(
        {"role": "assistant",
         "content": resp.content})

    for block in resp.content:
        if block.type == "tool_use":
            result = run_tool(
                block.name,
                block.input
            )
            messages.append({
                "role": "user",
                "content": [{
                    "type": "tool_result",
                    "tool_use_id": block.id,
                    "content": result
                }]
            })
            print(f"[Turn {turn+1}]"
                  f" {block.name}"
                  f"({block.input})"
                  f" → {result}")
else:
print("⚠️ 최대 턴 수 초과!")이 코드의 핵심을 정리하면요!
for turn in range(MAX_TURNS)— 안전하게 최대 횟수 제한- LLM이 도구를 호출하면 → 실행하고 결과를 돌려줌
- LLM이 텍스트만 반환하면 → 최종 답변, 루프 종료!
“서울이랑 도쿄 날씨 비교해줘”라고 하면, 에이전트는 get_weather("서울") → get_weather("도쿄")를 차례로 호출한 뒤, 결과를 비교해서 최종 답변을 만들어요. Think → Act → Observe가 자동으로 일어나는 거예요!
전체 코드는 GitHub 저장소에서 확인할 수 있어요.
⚔️ ReAct vs Plan-and-Execute
에이전트 루프에는 두 가지 대표적인 전략이 있어요.

ReAct (반응형) — 매 단계마다 생각하고 바로 행동해요. 유연하지만, 전체적인 큰 그림을 놓칠 수 있어요.
Plan-and-Execute (전략형) — 먼저 전체 계획을 세우고, 순서대로 실행해요. 더 정확하지만, 계획 단계에서 토큰을 많이 써요.
| 비교 항목 | ReAct | Plan-and-Execute |
|---|---|---|
| 방식 | 매 단계 생각→행동 | 계획 먼저 → 순차 실행 |
| 토큰 사용 | 2,000~3,000 | 3,000~4,500 |
| 정확도 | 85% | 92% |
| API 호출 | 3~5회 | 5~8회 |
| 적합한 상황 | 간단한 반응형 작업 | 복잡한 멀티스텝 작업 |
실무에서는 둘 중 하나만 쓰는 거야?
아니요! 실무에서는 하이브리드가 많아요. 전체 전략은 Plan-and-Execute로, 각 단계 실행은 ReAct로 하는 거예요. Claude Code도 이런 하이브리드 방식이에요!
⚠️ 에이전트 루프가 잘못될 때
에이전트 루프는 강력하지만, 실패할 수도 있어요. 2025년 연구에 따르면 멀티 에이전트 시스템의 실패율이 41~86.7%에 달한다고 해요 (arXiv:2503.13657).
대표적인 실패 모드를 알아볼게요:
| 실패 모드 | 설명 | 예시 |
|---|---|---|
| 🔄 무한 루프 | 같은 행동을 반복 | 같은 답을 58회 반복 출력 |
| 🔁 재귀적 실패 | 실패한 접근을 재시도 | 안 되는 방법을 100번 재시도 |
| 💬 대화 순환 | 종료 시점을 모름 | 에이전트끼리 끝없이 확인 요청 |
| ✅ 조기 완료 | 미완성인데 완료 선언 | “다 했어요!” (실은 안 했음) |
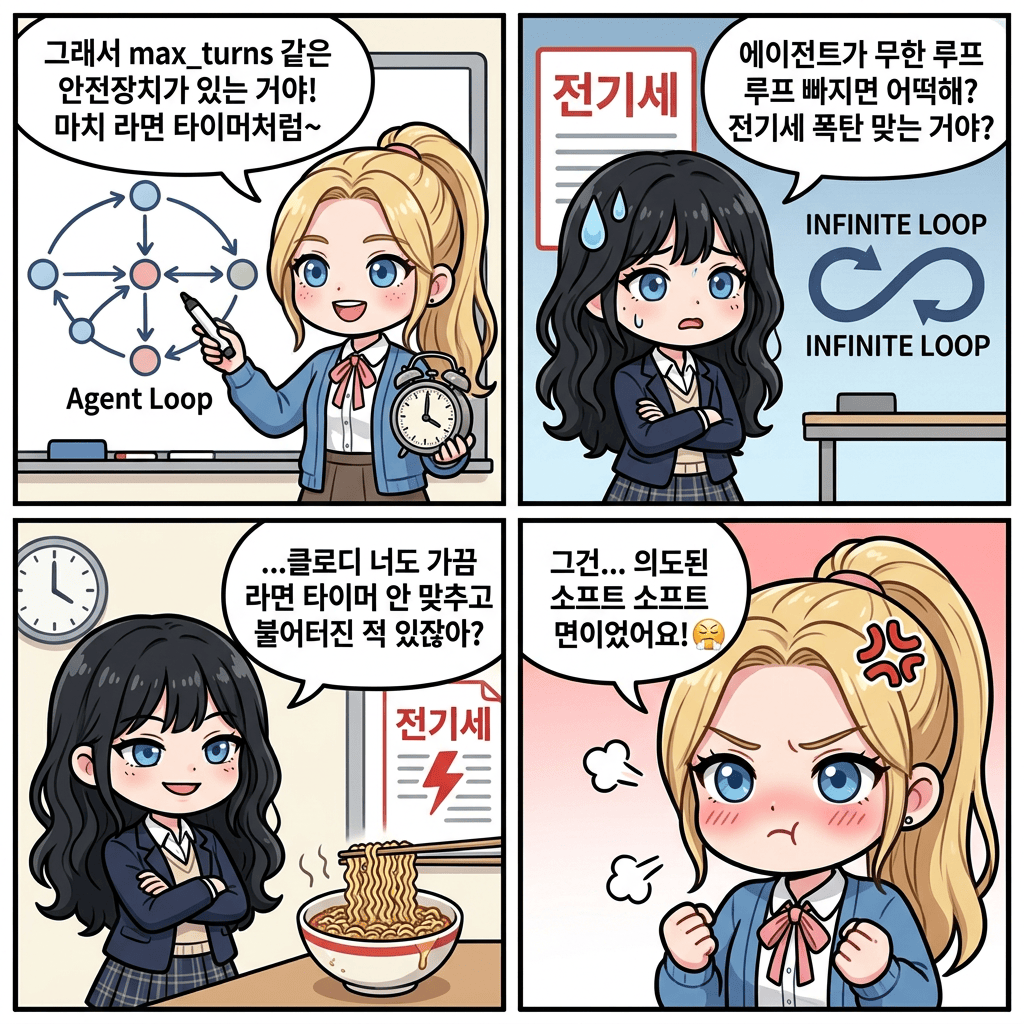
그러면 에이전트가 무한 루프 빠지면 어떡해? 전기세 폭탄 맞는 거야?
그래서 max_turns 같은 안전장치가 있는 거야! 마치 라면 타이머처럼~
…클로디 너도 가끔 라면 타이머 안 맞추고 불어터진 적 있잖아?
그건… 의도된 소프트 면이었어요! 😤
실패를 방지하려면 이런 안전장치가 필수예요:
- 반복 횟수 제한 —
max_turns로 하드캡 설정 - 비용 제한 —
max_budget_usd로 지출 상한 설정 - 진행률 추적 — 매 턴마다 진행 상태를 기록
- 결과 검증 — 단위 테스트뿐 아니라 end-to-end 검증
💰 숨겨진 비용 — 토큰 소비
에이전트 루프에는 숨겨진 비용이 있어요. 매 턴마다 시스템 프롬프트 + 도구 정의 + 전체 대화 히스토리 + 도구 입출력이 누적되거든요.
OpenReview 연구에 따르면, 같은 코딩 작업이라도 에이전트에 따라 토큰 소비가 10배 차이가 날 수 있다고 해요. 실행 전에 비용을 예측하기가 거의 불가능해요 (상관계수 r < 0.15).
그래서 Claude Agent SDK는 이런 최적화를 해요:
- 자동 압축(Compaction) — 컨텍스트가 길어지면 이전 내용을 요약
- 프롬프트 캐싱 — 반복되는 시스템 프롬프트를 캐싱
- 서브에이전트 — 독립 작업을 별도 에이전트로 분리해서 컨텍스트 폭발 방지

📝 오늘의 핵심 정리
- Agent Loop(에이전트 루프)는 “Think → Act → Observe”를 반복하는 구조예요. 이게 챗봇과 에이전트를 구분하는 핵심이에요.
- ReAct 패턴은 추론(Reasoning)과 행동(Acting)을 번갈아 수행하는 방식으로, 2022년 프린스턴대+Google 논문에서 제안됐어요.
- Claude Code의 핵심은 while 루프 하나예요 — 도구 호출이 있으면 계속, 없으면 종료!
- 에이전트 루프는 무한 루프, 재귀적 실패 등의 위험이 있어서
max_turns같은 안전장치가 필수예요. - 토큰 비용이 매 턴마다 누적되므로, 자동 압축과 서브에이전트로 최적화해야 해요.
- 다음 편에서는 이 에이전트 루프에 “성격”을 입히는 시스템 프롬프트 설계를 배울 거예요!
📚 References
- ReAct: Synergizing Reasoning and Acting in Language Models (Yao et al., 2022)
- Anthropic — How Claude Code Works
- Claude Agent SDK — How the Agent Loop Works
- Hugging Face — Agents Course: Thought-Action-Observation
- IBM — What is a ReAct Agent?
- Why Do Multi-Agent LLM Systems Fail? (2025)
- ReAct vs Plan-and-Execute: A Practical Comparison
- Anthropic — Effective Harnesses for Long-Running Agents
- How Do Coding Agents Spend Your Money? (OpenReview, 2025)
- Google Research — ReAct Blog Post
- 클로디의 Agentic AI 교실 2편 — LLM이 뭔지 알아보자
- 클로디의 Agentic AI 교실 3편 — Tool Use의 세계
- 클로디의 Agentic AI 교실 4편 — 컨텍스트와 메모리